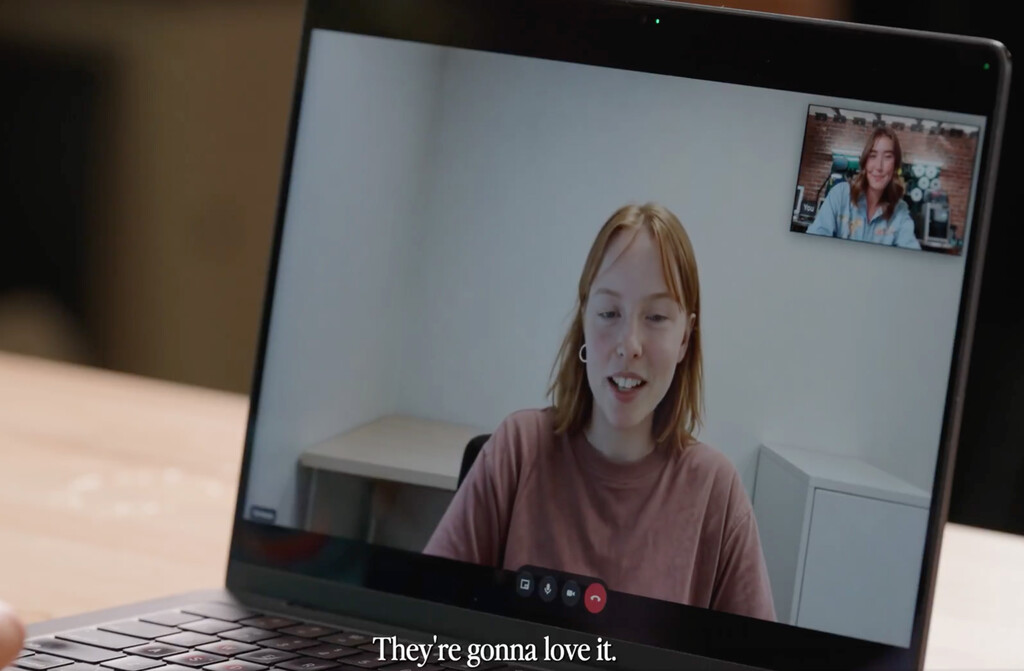
Una videollamada tiene algo que durante mucho tiempo hemos dado casi por sentado: si vemos a alguien reaccionar a lo que decimos, interrumpirnos, sonreír en el momento adecuado o mirar aquello que acabamos de enseñar a cámara, asumimos que hay una persona al otro lado. La inteligencia artificial lleva años complicando esa certeza con voces clonadas y vídeos sintéticos, pero mantener toda esa interacción en directo es otra historia. Y precisamente ahí es donde acaba de aparecer un modelo que pretende borrar buena parte de esa distancia.
Ese modelo se llama Griffin, aunque la versión que Tavus ha sometido a estas pruebas es Griffin-Lite, una versión preliminar de investigación. Su resultado más llamativo llega de un experimento realizado con 54 participantes: después de conversar durante un minuto con el sistema, 26 de ellos, el 48%, dijeron creer que su interlocutora había sido una persona real. La compañía sostiene que ese resultado convierte a Griffin en el primer modelo capaz de superar un "test de Turing en vídeo" en tiempo real. La afirmación, sin embargo, necesita bastante contexto.
Qué significa realmente pasar un test de Turing en vídeo
La clave está en cómo se planteó el experimento. Los 54 participantes, reclutados mediante una plataforma de investigación independiente, creían que iban a hablar durante un minuto con otra persona sobre qué cosas esperaban con ilusión de ese año. Al otro lado estaba Griffin-Lite, generando la conversación y la presencia audiovisual en directo. No se les pidió desde el principio que distinguieran entre humano e IA: esa cuestión apareció solo al final, después de valorar aspectos como naturalidad, confianza y fluidez. De los 54, 26 dijeron haber creído que su interlocutora era real; en una prueba equivalente con el sistema anterior de la compañía, solo 1 de 41 respondió lo mismo. El reclutamiento se realizó a través de una plataforma independiente, pero la prueba y sus resultados han sido publicados por la propia Tavus.
Aquí aparece el primer gran matiz. El planteamiento que Alan Turing publicó en 1950, del que deriva el test que hoy lleva su nombre, no incluía rostros, voces ni videollamadas: la comunicación debía realizarse por escrito, precisamente para que ninguna pista física condicionara la decisión del interrogador. Tampoco hay un protocolo único reconocido que funcione como "el" Video Turing Test. El término ya se había utilizado en investigación antes de Griffin: en 2023, por ejemplo, un trabajo publicado en AI Magazine presentó con ese nombre una prueba destinada a evaluar hasta qué punto una IA podía comprender vídeos de una forma comparable a un humano. Tavus está aplicando la idea de indistinguibilidad a un experimento diferente, basado en una conversación audiovisual cara a cara.
Hay, además, un precedente muy reciente en un test de Turing de tres participantes. Un estudio publicado en PNAS en mayo de 2026 hizo que cada interrogador conversara durante cinco minutos, por escrito y simultáneamente, con una persona y un modelo antes de decidir cuál de los dos era humano. GPT-4.5, cuando recibió instrucciones adicionales para adoptar una personalidad humana, fue escogido como la persona el 73% de las veces. Con el mismo modelo en la condición sin ese bloque de instrucciones de personalidad, la cifra quedó en el 36%. Los resultados no son comparables directamente con los de Griffin porque los protocolos son distintos: la novedad que reivindica Tavus está en trasladar esa confusión a una interacción audiovisual en directo.
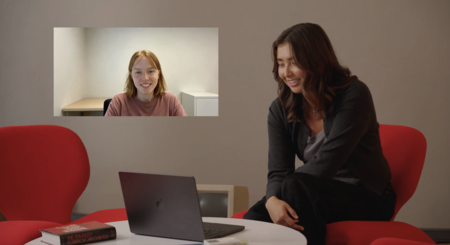 Griffin-Lite mantiene conversaciones audiovisuales en tiempo real y genera rostro, voz y respuestas sobre la marcha | Imagen: Tavus
La diferencia está en cómo funciona Griffin-Lite. El sistema no espera simplemente a que terminemos de hablar para empezar a reaccionar, sino que ha sido diseñado como un modelo full-duplex: mientras genera voz y vídeo continúa escuchando y observando, y vuelve a evaluar la conversación en intervalos inferiores a un segundo. Eso le permite asentir mientras hablamos, interpretar una pausa sin confundirla automáticamente con el final de nuestro turno, dejarse interrumpir o reaccionar a algo que mostramos ante la cámara. Voz, rostro, mirada y gestos se generan además a partir de las mismas decisiones conversacionales.
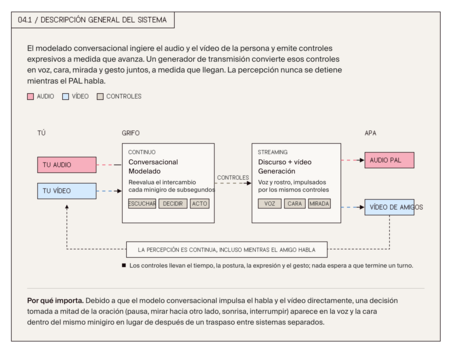 Así funciona la arquitectura conversacional full-duplex de Griffin-Lite, según Tavus (el gráfico original en inglés ha sido traducido al español) | Imagen: Tavus
Sí tenemos, en cambio, una referencia externa para comprobar esas capacidades. NVIDIA incluye Griffin-Lite en VideoFDB, un benchmark basado en 237 fragmentos de videollamadas reales y 11 dinámicas conversacionales. Sus rúbricas se puntúan de 0 a 5 mediante un juez basado en un modelo de lenguaje, y Griffin-Lite lidera actualmente las tablas publicadas de percepción, con 3,73 frente a 4,20 de la referencia humana, y de generación, con 3,83 frente a 3,92. NVIDIA subraya, no obstante, que los sistemas evaluados siguen por debajo de la referencia humana en naturalidad conversacional.
Todo esto tampoco significa que podamos entrar hoy en Tavus y poner a Griffin a atender nuestras videollamadas. La compañía ya comercializa una plataforma para crear los llamados PALs, agentes audiovisuales que pueden integrarse en productos mediante APIs, construirse sin código con PAL Maker o desarrollarse como soluciones empresariales a medida. Los orienta a usos como ventas, formación o atención al cliente. Griffin-Lite ocupa por ahora otro lugar: sigue siendo una versión de investigación disponible únicamente para un grupo de testers seleccionados y Tavus no la ofrece todavía a sus clientes. La empresa asegura que posteriormente llegará una versión más potente de Griffin.
 En Xataka Google ya tiene un chip de IA en órbita: lo ha lanzado SpaceX para comprobar si los centros de datos espaciales son viables
Y ahí aparece la otra cara de conseguir que una IA resulte tan convincente. Tavus reconoce que las mismas características que permiten una interacción más natural también pueden hacer creer a alguien que no está hablando con una IA, y afirma que trabaja en funciones de aviso para abordar ese riesgo antes de ampliar el lanzamiento. Su política actual exige consentimiento explícito e informado para crear una réplica con la imagen o la voz de una persona y obliga a informar de forma clara cuando alguien está interactuando con contenido generado o con un agente de IA. En la UE, además, el AI Act obliga desde el 2 de agosto de 2026 a que los sistemas diseñados para interactuar directamente con personas les informen de que están hablando con una IA, salvo cuando resulte evidente dadas las circunstancias.
Imágenes | Tavus
- La noticia Tenemos un nuevo modelo capaz de pasar el test de Turing en vídeo. O al menos eso dicen sus creadores fue publicada originalmente en Xataka por Javier Marquez .